Decision-1, 고객 문의 분류에 일반 LLM 대신 써도 될까?
결제팀과 기술팀의 업무 범위가 겹치는 문의라면, 모델이 내놓은 가장 높은 확률만으로 자동 배정해도 될까?
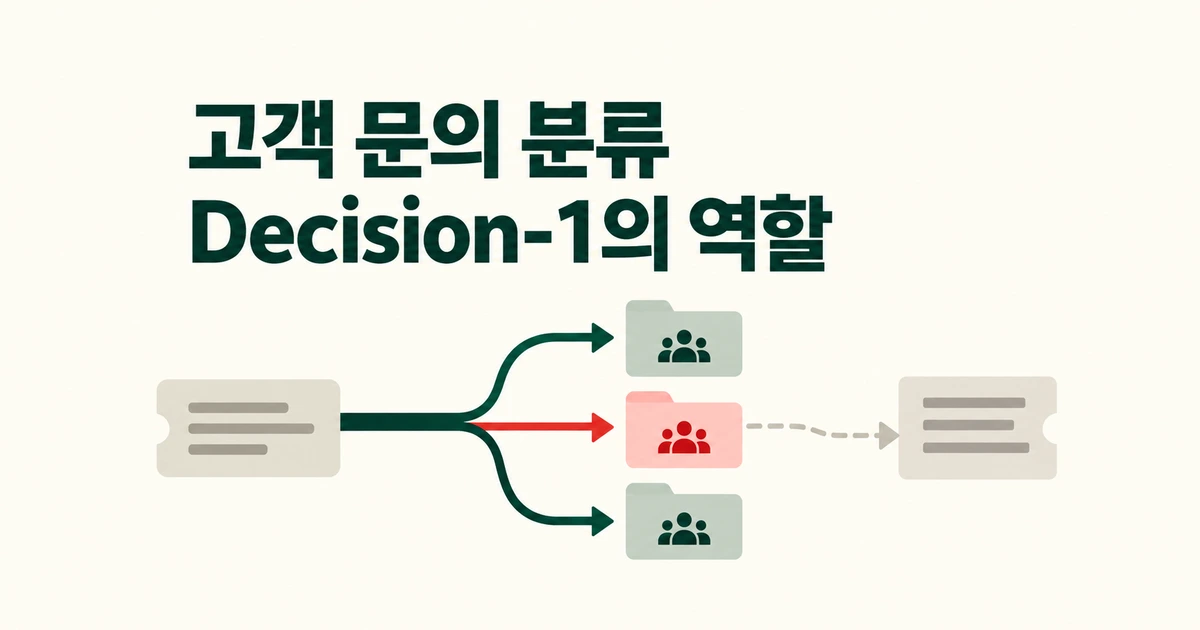
- Microsoft-Decision-1은 정해진 선택지 중 담당팀을 고르고 확률을 반환한다. 고객에게 보낼 답변이나 판단 이유는 만들지 않는다.
- 입력 100만 토큰당 0.042달러이며 출력 요금은 없다. 문의 건수가 아니라 실제 입력 토큰으로 비용을 계산한다.
- 자동 배정 기준은 실제 문의 데이터로 정해야 한다. 애매한 문의를 넘길 ‘판단 불가’ 선택지와 검토 경로도 필요하다.
담당팀을 고르는 단계라면 Decision-1을 쓸 수 있다
고객 문의를 결제팀·기술팀·계정 지원팀 중 어디로 보낼지 결정하는 작업에는 긴 답변이 필요하지 않다. Microsoft-Decision-1은 이런 제한된 선택을 위한 모델이다. 문의 내용과 각 팀의 담당 범위를 넣으면, 미리 지정한 선택지 가운데 하나와 선택지별 확률을 돌려준다.
반면 고객에게 보낼 사과문을 쓰거나 장애 원인을 문장으로 설명하는 일은 생성 모델의 역할이다. Decision-1이 담당팀을 골랐다고 해서 문의가 실제 대기열로 이동하는 것도 아니다. 반환값을 받아 배정하는 기능은 애플리케이션이 맡고, 답변이 필요하면 그 뒤에 생성 모델을 연결한다.
마이크로소프트는 10월 9일 이 모델을 공개했다. 공식 발표에 따르면 Qwen3.5-9B를 추가 학습했으며 Microsoft Foundry와 OpenRouter에서 제공한다. 새 모델의 도입 여부는 ‘더 똑똑한 챗봇인가’보다 ‘지금 필요한 결과가 문장인가, 정해진 항목의 선택인가’로 판단하는 편이 맞다.
담당팀은 choice, 긴급도는 score로 묻는다
같은 문의에서도 필요한 답의 모양이 다르다. 담당팀은 하나를 고르면 되지만, 긴급도는 낮음부터 높음까지 순서가 있고, 재문의 여부는 참·거짓으로 물을 수 있다. Decision-1은 이를 서로 다른 질문 유형으로 받는다.
| 필요한 판단 | 유형 | 돌아오는 값 |
|---|---|---|
| 어느 팀이 담당하는가 | choice | 선택한 항목 하나와 각 선택지의 확률 |
| 재문의인가 | noul | 조건이 참일 확률, 0~1 |
| 얼마나 긴급한가 | score | 순서가 있는 척도의 점수와 단계별 확률 |
예를 들어 긴급도를 네 단계로 정의하면 score는 0~3 범위에서 단계별 확률로 가중 평균한 값을 반환한다. 1.7처럼 단계 사이의 값도 가능하다. 이를 ‘정확도 57%’처럼 읽으면 안 된다. 정해 둔 긴급도 척도에서 어느 위치에 놓이는지를 나타내므로, 문의 처리 순서를 정하는 데 활용할 수 있다.
입력의 state에는 텍스트나 JSON을 넣고, questions에는 판단할 질문과 기준을 넣는다. 같은 문의에 대한 담당팀·긴급도·재문의 여부를 한 요청에 함께 묻는 것도 가능하다. 다만 결제팀과 기술팀의 담당 범위가 겹친다면 선택지 이름만 나열하지 말고, 어떤 경우에 어느 팀이 맡는지 기준을 구체적으로 써야 한다.
100만 건이 42달러라는 계산에는 건당 1,000토큰 조건이 붙는다
2026년 10월 26일 확인한 공식 가격은 입력 100만 토큰당 0.042달러이고, 출력 토큰은 무료다. ‘문의 100만 건당 0.042달러’가 아니다. 문의 본문뿐 아니라 분류에 쓰는 질문과 기준을 포함한 입력량이 계산의 출발점이다.
다음은 실제 고객 청구서가 아니라 입력량을 가정한 계산 예시다. 재시도와 다른 모델 호출 없이 문의마다 한 번씩 분류한다고 가정했다.
| 문의 건수 | 건당 입력 가정 | 총 입력 토큰 | 모델 입력 요금 |
|---|---|---|---|
| 10만 건 | 1,000토큰 | 1억 토큰 | 4.20달러 |
| 100만 건 | 1,000토큰 | 10억 토큰 | 42달러 |
| 100만 건 | 3,000토큰 | 30억 토큰 | 126달러 |
고객 응답을 만드는 모델의 요금, 서버 운영비, 사람이 검토하는 비용은 이 표에 들어 있지 않다. 실제 예산을 잡으려면 대표 문의를 넣었을 때 반환되는 토큰 사용량부터 측정해야 한다. 짧은 문의와 긴 상담 이력을 같은 건당 비용으로 계산하면 총액이 달라진다.
자동 배정 기준은 정답을 붙인 문의로 정한다
가장 높은 확률의 팀을 무조건 선택하면 애매한 문의도 자동 배정된다. Microsoft Learn의 권장 방식은 실제 업무를 대표하는 데이터로 평가하고, 오분류의 비용에 맞춰 확률 기준을 정하는 것이다. 모든 회사에 통하는 고정 임계값은 제시하지 않는다.
실무에서는 기존 문의에 올바른 담당팀을 표시한 뒤 모델의 결과와 대조할 수 있다. 잘못 보낸 문의를 되돌리는 비용이 큰 업무라면 자동 처리 범위를 좁히고, 낮은 확률의 결과는 사람이나 다른 모델에 넘기는 편이 적절하다. 선택지에 cannot tell처럼 판단을 보류할 항목을 넣으면, 정보가 부족한 문의까지 억지로 어느 팀에 배정하는 일을 줄이는 설계를 할 수 있다.
질문 문구와 선택지 순서를 바꿨을 때 결과가 달라지는지도 평가 대상이다. 모델이 숫자를 돌려준다는 사실은 그 숫자가 모든 업무에서 같은 신뢰도를 갖는다는 뜻이 아니다. 특히 Decision-1은 판단 이유를 서술하지 않으므로, 검토 담당자는 원래 문의와 분류 기준을 함께 볼 수 있어야 한다.
Foundry에서 연결할 때는 전용 Decision API를 사용한다. 요청의 model 값은 카탈로그 이름이 아니라 자신이 만든 배포명이다. 먼저 문의 분류 한 단계를 붙여 정확도·입력량·검토 비율을 확인하면, 기존 생성 모델에 맡기던 작업 중 어디까지 분리할지 판단할 수 있다.