클로드 코드 vs 코덱스: 언어·프레임워크별로 먼저 써 볼 도구
같은 TypeScript여도 React 화면 이전과 Zod 오류 수정에서 좋은 결과의 기준은 달랐다. Python·Go·Rust·Swift를 쓰는 개발자는 어떤 도구와 모델부터 시험하면 될까?
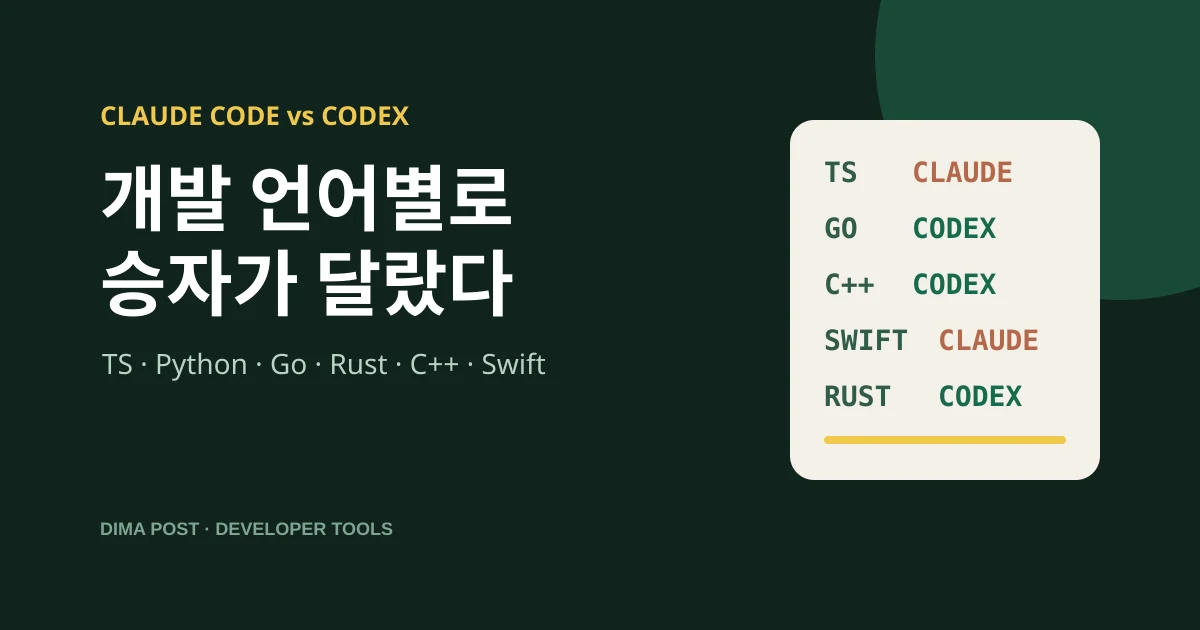
React 화면을 만들고 다듬는 일과 Ruby/Rails 기능 구현은 Claude Code의 Opus 5.5부터, 요구사항이 정해진 Go·TypeScript 저장소 수정은 Codex의 GPT-6.1 Sol부터 시험할 만하다. Python·Rust·C++는 지금 쓰는 구독에서 시작하고, Swift의 기존 앱은 Claude Code에 작은 기능부터 맡겨 보는 쪽을 권한다. 이 차이는 언어 문법 점수보다 브라우저 사용, 기존 코드 재사용, 테스트와 변경 범위를 얼마나 잘 다루는지에서 나온다.
언어와 맡길 작업에 따라 먼저 써 볼 도구가 달라진다
아래는 2026년 11월 2일 기준의 첫 시도 추천이다. Claude Code와 Codex는 개발 도구이고, Opus와 GPT는 그 안에서 실행하는 모델이다. 같은 이름의 도구도 모델과 추론 설정이 바뀌면 결과가 달라진다. OpenAI의 현재 안내에 따르면 GPT-5.5는 10월 14일 ChatGPT 로그인 방식의 Codex에서 은퇴했다. API 키로 쓰는 경우는 이 변경의 대상이 아니다.
| 언어·맡길 일 | 먼저 시험할 도구 | 근거의 시점·모델·강도 |
|---|---|---|
| React·Next.js 화면 구현 | Claude Code / Opus 5.5 | 1개월 전으로 표시된 Opus 5 대 GPT-5.6 Sol 앱 이전 사용기. 둘 다 Medium. 브라우저 검증 차이가 컸다. 현행 추천은 후속 Opus 경험을 더한 판단이다. |
| TypeScript 라이브러리·Go 이슈 수정 | Codex / GPT-6.1 Sol Medium | 과거 GPT-5.5 대 Opus 4.7의 56과제 비교와 10월 12일 Sol 세대 간 24과제 측정. 현행 GPT-6.1 Sol과 Opus 5.5를 직접 비교한 결과는 아니다. |
| Python 스크립트·데이터 처리 | 이미 쓰는 도구 | 작은 앱의 Claude 호평은 2025년 Sonnet 4 대 GPT-5-Codex Medium. 현재 언어 승자를 정할 자료로는 오래됐다. |
| Rust 구현·리뷰 | 이미 쓰는 도구, 리뷰는 양쪽 후보 | 10월 17일 CodePanel의 Rust 리뷰에서 Sol 6.1·Opus 5.5·Sonnet 5.5 동률. 구현 속도와는 다른 측정이다. |
| C++ 기존 프로젝트 계획 | 현재 도구부터, 누락이 반복되면 Codex | 6개월 전으로 표시된 약 1만 줄 프로젝트 개인 경험. 작성자의 모델·추론 설정은 미명시. |
| Swift·Objective-C 기존 앱 | Claude Code / Opus 5.5를 작은 변경부터 | 5개월 전 패턴 재사용 호평은 모델 미명시. 최근 SwiftLee의 Opus 5.5 호평은 Cursor 경험이며 Codex 직접 비교가 없다. |
| Ruby/Rails 기존 기능 | Claude Code / Opus 5.5 | 9월 22일 Every의 기존 앱 구현·개발자 선호. 언어별 첫 선택의 현행 경험 근거가 비교적 구체적이다. |
| Java 테스트로 검증할 구현 | Codex / GPT-6.1 Sol도 유력한 후보 | 10월 9일 Sonar의 Medium 모델 측정. Claude와의 에이전트 대결·개발자 선호 조사는 아니다. |
가격과 개발 환경까지 포함해 첫 구독을 고르는 질문은 클로드 코드·코덱스 종합 비교에서 다룬다. 여기서는 이미 가진 코드의 어떤 작업을 먼저 맡길지에 집중한다.
TypeScript·React: 화면 조작과 라이브러리 수정은 평가 기준이 다르다
개발자 notherealironman의 앱 이전 비교는 약 2,000줄의 Python/Streamlit 코드를 같은 가이드로 Next.js·TypeScript로 옮긴 단일 사례다. 작성자 댓글에 따르면 Opus 5와 GPT-5.6 Sol을 모두 Medium으로 실행했다. Codex는 27분, Claude Code는 37분이 걸렸지만, Codex 결과를 브라우저에서 동작시키려면 추가 지시가 두 번 필요했다.
Claude는 브라우저로 검증했고 작성자는 간격·정렬을 더 좋게 평가했다. 반면 Codex의 반응형 배치는 더 낫다고 봤다. Claude는 코드도 두 배쯤 작성했고 문맥·토큰 사용도 약 1.5배였다. 따라서 React를 쓴다는 이유만으로 Claude가 더 정확하다고 결론 낼 수는 없다. 화면에서 직접 눌러 보고 고치는 일까지 맡겼을 때, 첫 결과의 동작이 더 좋았던 사례다.
현재 React 제품 작업을 새로 맡긴다면 Opus 5.5부터 시험하되, 로그인·저장·좁은 화면에서의 조작까지 완료 조건으로 준다. 아래 Ruby/Rails의 후속 모델 경험도 이 추천을 뒷받침한다. 기존 Codex 설정에서 브라우저를 쓰지 못한다면 브라우저를 열고 조작할 수 있도록 설정한 뒤 비교한다.
반대로 Zod의 타입 추론이나 변환 규칙처럼 정답을 테스트로 정할 수 있는 수정은 Codex부터다. Stet 제작자가 공개한 과거 비교에서 Zod 27개 과제의 테스트 통과는 GPT-5.5와 Opus 4.7이 각각 12개로 같았다. 테스트와 자동 코드 리뷰를 모두 통과한 패치는 각각 10개와 5개였다. 화면 완성도와 라이브러리 패치의 유지보수성은 다른 결과이므로, 같은 TypeScript 우위 한 줄로 묶기 어렵다.
Go: 오류를 재현할 수 있고 요구사항이 정해졌다면 Codex부터
같은 과거 평가의 graphql-go-tools 29개 과제에서 GPT-5.5는 테스트 26개, 테스트와 자동 리뷰 동시 통과 18개였다. Opus 4.7은 각각 21개와 5개였다. 두 도구의 기본 설정으로 과제당 한 번 실행했고, 테스트 외 평가는 GPT-5.4가 맡았다. 사람의 병합률을 센 실험은 아니지만, Go 이슈를 완성하는 능력에서는 당시 Codex 쪽 근거가 더 분명했다.
현재 모델의 근거는 Stet의 10월 12일 평가다. 제작자 자신의 Go·TypeScript 저장소에서 실제 병합 변경 24개를 재현했고, 두 Sol 모델을 Codex Medium으로 한 번씩 실행했다. Sol 6.1은 이전 Sol 대비 종합 평가에서 9승·10무·5패였지만 정확성 평균은 0.638에서 0.606으로 낮아졌다. 변경량 중앙값도 197줄에서 303줄로 늘었다.
그래서 Go 백엔드에서 오류를 재현할 수 있고 요구사항이 정해진 이슈에는 GPT-6.1 Sol부터 권한다. 테스트 통과 여부와 함께 요청한 동작을 모두 구현했는지, 불필요하게 바꾼 코드는 없는지 살펴야 한다. GraphQL 변경이라면 정상 응답뿐 아니라 잘못된 요청·취소·호환 동작도 본다. 다만 과거 직접 비교의 Claude 모델은 Opus 4.7이었고, 현행 Sol의 평가에는 Opus 5.5가 참여하지 않았다. 두 현행 모델의 점수 차이는 이 자료로 알 수 없다.
Python: 작은 앱은 구조를, 데이터 변환은 처리 결과를 살핀다
Spooknik의 2025년 9월 사용기는 작은 Python 앱에서 Claude를 선호한 사례다. Sonnet 4와 GPT-5-Codex Medium에 PDF 추출·Streamlit 앱을 맡겼더니, Codex가 두 번째 가상환경과 복잡한 폴더를 만들었고 Claude는 실행법과 구조를 더 잘 정리했다는 경험이다. 비교 대상이 이전 모델이므로, 지금 Opus 5.5와 Sol 6.1 중 어느 쪽이 작은 Python 앱을 더 단순하게 만드는지는 이 사례로 알 수 없다.
지금은 이미 쓰는 도구에 기존 가상환경 경로, 새로 추가해도 되는 의존성, 입력 PDF와 기대 텍스트를 주는 것으로 시작하는 편이 낫다. 구조가 커지는 문제가 반복되면 다른 도구에 같은 입력으로 작은 기능 하나를 맡긴다. 화면이 있는 Streamlit 앱은 실행 성공과 버튼 동작을 함께 보고, 추출기는 샘플 파일별로 빠진 글자·표·빈 페이지 처리를 본다.
데이터 변환의 정확도는 실제 처리 결과로 판단해야 한다. 경제학자 Claes Bäckman의 현재 Codex 연구 작업 가이드는 R·Stata·Python을 포함한 전체 프로젝트 폴더를 열고, 스크립트·로그·출력물을 함께 다루는 방법을 보여 준다. 이 환경을 갖췄다면 Codex를 실제 데이터 작업의 후보로 삼을 만하다. 어느 도구든 실행 시간에 더해 병합 전후 행 수, 중복 키, 결측치, 집계 합계와 몇 개의 실제 레코드를 비교해야 한다.
사용량이 부족해 도구를 바꾸려면 현재 요금제의 한도도 살펴야 한다. 11월 2일 Claude 공식 안내에서 Ultra는 월 200달러(27만4,000원, 세전)이며 인증 계정의 5시간 제한이 없고 주간 한도는 남는다. Codex 공식 요금 안내도 모델과 작업 크기에 따라 사용량이 달라진다고 설명한다. 옛 사용기의 “Codex가 더 오래 간다”를 오늘의 Python 능력이나 고정된 작업 개수로 읽으면 안 된다.
Rust·C++: 버그를 찾는 능력과 구현·계획 능력을 구별한다
CodePanel의 10월 17일 Rust 코드 리뷰 결과에서는 GPT-6.1 Sol, Opus 5.5, Sonnet 5.5가 해당 표본의 알려진 버그를 모두 찾아 동률이었다. 이 평가는 CodePanel의 리뷰 절차 안에서 결함을 찾는 능력이다. 새 Rust 프로그램의 구현 성공률이나 Claude Code 대 Codex의 완료 시간을 잰 것은 아니다.
최근 Escobar747의 Rust 중심 저장소 실험도 작업 구분을 잘 보여 준다. 게시 화면은 10일 전으로 표시된다. 작성자는 숨긴 테스트와 답을 먼저 만든 뒤 Haiku 5.5의 여러 설정, Sonnet 5.5 Medium, GPT-6 Luna High, GPT-6.1 Sol Medium을 시험했다. 명세가 분명한 구현·버그 수정에서는 거의 차이가 없었지만, 언어 경계를 넘어 기존 관례를 따르는 작업에서는 설정별 검증 행동이 갈렸다. 일상적인 Rust 구현에서는 현재 도구를 유지하고, 기존 관례를 놓치거나 검증을 건너뛰는 작업부터 다른 도구와 비교할 만하다.
Rust는 현재 쓰는 도구에 같은 재현 사례와 cargo check·테스트를 주고 시작한다. borrow checker를 통과해도 불필요한 복제, 잠금 범위, 작업 취소 처리가 남을 수 있다. Bevy 화면 오류라면 빌드만 보고 끝내지 말고 같은 장면을 실행해야 한다. 과거 Claude의 좋은 Rust 후기로 인용됐던 토론에는 Zed 구독으로 Claude를 쓴 경험도 들어 있어, 이를 모두 Claude Code의 실적으로 셀 수는 없다.
C++에서 Codex를 칭찬한 fourier54의 6개월 전 사용기는 약 1만 줄 프로젝트의 계획 비교다. 같은 프롬프트로 만든 계획을 서로 읽혔을 때 Codex가 Claude 계획의 누락을 찾았다고 한다. 모델과 추론 설정은 명시되지 않았으며, 그 글만으로 현재 C++ 구현의 우위를 정할 수 없다. 지금 도구가 변경할 호출부나 수명 조건을 자꾸 빠뜨린다면 Codex에 두 번째 계획을 맡길 실용적 이유는 있다. 채택 여부는 기존 빌드·테스트와 실제 누락으로 정한다.
Swift·Objective-C: 기존 코드를 재사용한 Claude Code 경험이 있다
imperfectlyAware의 macOS 앱 경험은 현재 화면에서 5개월 전 댓글로 표시된다. 자체 Swift·Objective-C 프레임워크가 얽힌 앱에서 Codex가 기존 기능을 중복 구현하는 반면 Claude Code는 유사한 기존 코드를 찾아 작은 수정으로 해결했다는 평가다. 해당 댓글에는 모델과 추론 설정이 없어, 추천 범위는 이런 기존 패턴 재사용 작업이다.
최근 자료인 SwiftLee Weekly 343호에서 Antoine van der Lee는 한 주에 앱 두 개를 배포 단계로 옮겼다고 전하며 Opus 5.5의 코드 품질을 호평했다. 그는 Cursor에서 Opus를 썼으며 GPT-6와는 비교하지 못했다고 밝혔다. 따라서 이 후기는 현행 Opus의 Swift 개발 경험을 보여 주지만, Claude Code와 Codex 중 어느 도구가 더 나은지는 알려 주지 않는다.
따라서 오래된 Apple 앱의 기존 구현 방식을 따라 코드를 재사용하는 작업이라면 Claude Code의 Opus 5.5부터 시험할 만하다. 이미 Cursor에서 Opus가 잘 작동한다면 이 후기 때문에 실행 도구까지 바꿀 이유는 없다. 새 SwiftUI 화면은 배포 대상 OS의 API에 맞는지 살피고, 상태 복원·접근성과 실제 기기에서의 조작까지 보고 선택한다. Apple SDK 탐색 능력은 이런 Apple 앱 작업에서 판단해야 한다. 웹 UI를 잘 만들었다는 후기만으로는 알 수 없다.
Ruby/Rails는 Opus 5.5 구현 사례, Java는 Sol 테스트 결과가 있다
Every의 9월 22일 사전 사용 보고에서 Kieran Klaassen은 같은 Ruby 작업의 Fable 5.1 High 결과보다 Opus 5.5 Extra-high의 관용적인 코드를 선호하고 일상 모델을 바꾸겠다고 했다. Mike Taylor의 Rails 파일 업로드 기능도 Opus가 약 8분에 구현해 자동 검사 5개 중 4개를 통과했고, 남은 문제는 변경 크기였다. 기존 Ruby/Rails 앱의 기능을 맡길 때 Opus 5.5를 먼저 권할 실제 경험 근거다. 다만 필요 이상으로 코드를 바꾸지는 않았는지 살펴야 한다.
Java에서는 Sonar의 10월 9일 모델 평가가 있다. Medium 설정의 GPT-6.1 Sol은 실행 테스트가 있는 544개 과제 중 85.29%를 통과해 이전 Sol의 83.09%보다 높았다. 전체 코드 분석 대상은 4,444개였고 생성 코드와 분석기 지적 총량도 늘었다. Java 구현 후보로 Sol을 시험할 근거이지, Spring 저장소에서 Claude Code보다 개발자가 선호한다는 조사는 아니다. 기존 팀 도구가 있다면 전환보다 실제 빌드와 통합 테스트를 실행하게 하는 것이 먼저다.
작은 기능의 실제 동작과 최종 수정량으로 도구를 고른다
표에서 첫 후보를 골랐다면 새 언어를 공부시키는 과제보다 지금 막힌 작업 하나를 준다. 같은 시작 커밋에서 실행하고, 모델·추론 설정·실행 환경을 남겨야 나중에 무엇이 달라졌는지 알 수 있다. 같은 Medium이라는 이름도 업체 사이에서 동일한 연산량을 뜻하지 않는다.
| 스택 | 첫 과제로 적합한 일 | 결과를 받아들일 기준 |
|---|---|---|
| React·Next.js | 데이터를 저장하는 기존 폼 수정 | 빈 값·오류·좁은 화면에서 직접 조작하고 저장 결과까지 본다. |
| Go·TypeScript 라이브러리 | 실패 입력이 있는 이슈 하나 | 재현 테스트와 기존 테스트가 통과하고 요청한 동작이 모두 구현돼 있다. |
| Python·R·Stata | 작은 샘플의 병합·변환 | 키·행 수·결측치·합계와 실제 샘플 값이 맞는다. |
| Rust·C++ | 재현 가능한 오류나 작은 설계 변경 | 기존 빌드·테스트가 통과하고 소유권·수명·동시성에 관한 가정이 맞는지 사람이 검토한다. |
| Swift·Rails·Java 앱 | 기존 패턴으로 구현할 작은 기능 | 기존 구현을 재사용하고 실제 SDK·DB 환경에서 주요 동작이 끝난다. |
이 표는 이 글의 시험 제안이다. 초안이 나온 시간에 더해 추가 지시, 사람이 고친 코드, 최종 실행까지의 시간을 본다. 두 도구가 서로 지적을 반복하면 교차 리뷰를 끝내는 기준처럼 재현되는 결함부터 고친다. 지금 쓰는 스택에서 제대로 돌아가고 검토할 변경이 적게 남는 도구가 다음 작업을 맡을 도구다.
자주 묻는 질문
React와 TypeScript에는 Claude Code가 더 좋은가?
브라우저에서 화면과 동작을 함께 다듬는 작업은 Claude Code의 Opus 5.5부터 시험할 만하다. 근거가 된 이전 사례는 Opus 5와 GPT-5.6 Sol의 단일 앱 비교다. 명세가 정해진 TypeScript 라이브러리 수정은 Codex의 GPT-6.1 Sol부터 시험할 근거가 있어 작업을 나눠야 한다.
Go 백엔드는 Codex가 확실히 앞서는가?
먼저 시험할 도구로는 Codex를 권한다. 다만 과거 29개 Go 과제의 직접 비교는 GPT-5.5와 Opus 4.7이고, 현재 GPT-6.1 Sol 측정은 이전 Sol과의 비교다. 이 자료에는 현행 GPT-6.1 Sol과 Opus 5.5 사이의 승률이 없다.
Rust와 C++도 Codex를 고르면 되는가?
Rust의 현행 코드 리뷰 측정은 GPT-6.1 Sol과 Opus 5.5가 동률이었다. C++의 Codex 계획 호평은 6개월 전으로 표시된 약 1만 줄 프로젝트의 개인 경험이다. 이미 쓰는 도구에서 빌드·테스트를 실행하게 하고 실제 누락과 수정량으로 선택하는 편이 낫다.
Swift 앱은 Claude Code를 먼저 써도 되는가?
기존 Swift·Objective-C 패턴을 따라야 하는 앱이라면 Claude Code부터 시험할 만하다. 다만 과거 직접 비교는 모델이 명시되지 않았고, 최근 Opus 5.5 호평은 Cursor를 쓴 개발자의 경험이다. Xcode 빌드와 실제 화면에서 작은 기능 하나가 완성되는지로 판단한다.