M5 로컬 AI 성능, 첫 응답 4배와 생성 25%의 차이
긴 문서를 넣은 로컬 AI가 첫 글자를 보여줄 때까지 한참 기다린다. M5 벤치에서 첫 응답은 약 4배 빨라졌는데, 이후 글이 나오는 속도는 왜 25% 안팎만 늘었을까?
M5에서 로컬 AI의 첫 응답이 약 4배 빨라져도 답변 전체가 4배 빨라지는 것은 아니다. Apple의 MLX 시험에서는 긴 입력을 처리하는 단계가 크게 단축됐고, 이후 토큰 생성 속도는 19~27% 높아졌다. 새 문서를 읽히는 시간이 긴지, 답변이 이어지는 시간이 긴지에 따라 체감하는 이득이 갈린다.
- M5의 로컬 AI 성능은 응답 시작과 이후 생성을 나누면 이해하기 쉽다. 입력을 처리하는 GPU 연산과 다음 토큰을 만들 때의 메모리 접근은 병목이 다르다.
- Apple의 MLX 비교에서 첫 토큰 응답은 M4 대비 약 3.3~4.1배, 이후 생성 속도는 19~27% 높았다. 입력 4,096토큰·추가 생성 128토큰의 제조사 시험이다.
- 긴 입력·짧은 답변과 짧은 입력·긴 답변의 전체 시간 이득은 다르다. 모델·양자화·입출력 길이·캐시·OS와 런타임을 함께 맞춰야 같은 작업의 차이가 드러난다.
첫 글자가 뜨기 전과 글이 이어지는 동안
로컬 AI에 문서를 넣고 요약을 요청하면, 먼저 입력을 읽고 그다음 답변을 이어 만든다. 앞의 대기는 첫 토큰까지 걸린 시간인 TTFT로, 뒤의 속도는 초당 생성 토큰 수로 표현한다. 토큰은 모델이 글을 처리하는 단위여서 한글 한 글자나 영어 한 단어와 항상 일치하지 않는다. 같은 답변 화면에도 서로 다른 두 대기가 있는 셈이다.
Apple의 M5 GPU 기술 설명은 입력 전체를 처리하는 prefill과 토큰을 하나씩 생성하는 decode를 나눈다. 전자는 큰 행렬 연산이 많고, 후자는 계산에 필요한 데이터를 메모리에서 읽는 속도의 영향을 크게 받는다. 연산 장치가 크게 빨라져도 데이터를 가져오는 속도가 같은 비율로 늘지는 않아, 두 단계의 개선 폭이 갈린다.
긴 회의 자료를 처음 넣고 짧은 요약을 받는 작업에서는 응답 시작까지의 대기가 두드러진다. 반대로 짧게 지시하고 긴 보고서를 만드는 작업에서는 첫 문장이 나온 뒤 기다리는 시간이 커진다. 두 상황 모두 같은 모델을 써도 사용자가 답답하다고 느끼는 구간은 다르다. 벤치에서 ‘AI 속도’ 하나만 떼어 읽으면 이 차이가 사라진다.
M5의 GPU 가속기는 Neural Engine과 별개다
Apple의 2025년 M5 발표는 GPU 각 코어의 Neural Accelerator와 16코어 Neural Engine을 따로 설명한다. 이름에 모두 신경망이 들어가지만 같은 장치를 두 번 부른 것이 아니다. MLX의 GPU 행렬 연산이 빨라진 결과를 Neural Engine 코어 수 증가로 설명하면 사용된 연산 경로부터 달라진다.
또한 발표의 AI 피크 GPU 연산 성능과 그래픽 성능 향상은 서로 다른 항목이다. 문장을 만드는 행렬 연산, 게임의 화면 렌더링, 영상 출력이 동일한 연산을 같은 비중으로 쓰지는 않는다. AI용 가속기의 이득이 큰 작업을 일반 GPU 작업 전체의 예상 성능으로 옮길 이유가 없는 것이다.
M5의 공식 메모리 대역폭은 153GB/s이고 비교 대상 M4는 120GB/s다. 두 수치의 산술 차이는 27.5%다. 메모리에서 많은 데이터를 반복해 가져오는 작업에는 관련 있는 차이지만, RAM 용량이나 모든 앱의 처리 시간이 그만큼 늘고 줄었다는 뜻은 아니다. 이 숫자는 칩의 대역폭 사양이며 실제 모델의 생성 속도는 별도 측정값이다.
같은 입력 4,096토큰에서 달라진 두 배율
Apple ML Research의 2025년 11월 19일 비교는 M5 맥북프로 24GB와 유사하게 구성한 M4를 MLX로 시험했다. 입력은 4,096토큰이고 생성 속도는 추가 128토큰에서 평가했다. 표는 대표 세 모델을 추린 것이다. 같은 행의 M4를 기준으로 하며 다른 모델끼리의 절대 속도 순위는 아니다.
| 모델·정밀도 | 첫 토큰 응답 배율 | 이후 생성 배율 |
|---|---|---|
| Qwen3-8B·MLX 4bit | 3.97배 | 1.24배 |
| Qwen3-14B·MLX 4bit | 4.06배 | 1.19배 |
| gpt-oss-20b·MXFP4-Q4 | 3.33배 | 1.24배 |
여기서 첫 응답 4배는 같은 단계의 시간이 약 4분의 1이라는 뜻이다. 생성 속도 1.24배라면 같은 수의 후속 토큰을 만드는 시간은 약 80.6%다. 속도가 24% 높다는 표현과 시간이 24% 짧다는 표현은 계산이 다르다.
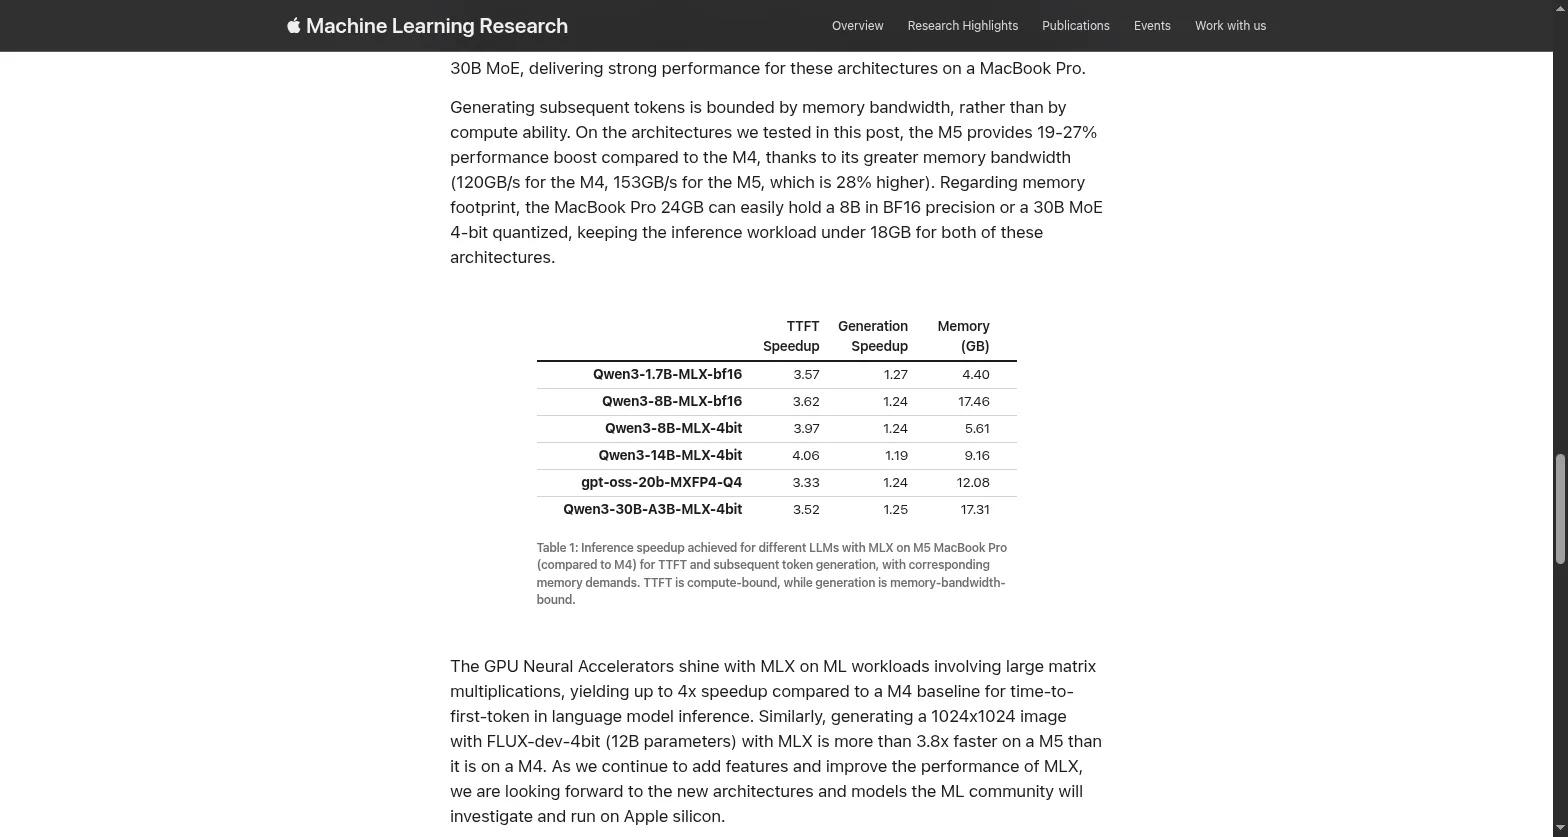
자료의 가속 조건은 macOS 26.2 이상이다. M5라는 칩 이름만 같고 실행 환경이 다른 앱에 이 표를 적용하지 않는다. 또한 원문에 없는 MLX 세부 버전이나 SSD·전원 조건을 임의로 채워 통제 실험처럼 소개할 수는 없다. 이 표는 해당 제조사 시험에서 두 단계가 다르게 개선됐다는 자료다.
응답 시작이 4배 빨라도 전체 시간은 달라진다
첫 응답과 이후 출력의 비중을 나누면 전체 이득도 계산할 수 있다. 다음은 첫 응답 구간 4배, 후속 생성 속도 1.25배를 가정한 산술 예시다. 실제 맥에서 잰 시간이 아니며, 모델을 처음 불러오는 시간이나 문서에서 글자를 추출하는 시간은 넣지 않았다.
| 가정한 작업 | 기존 첫 응답+후속 생성 | 개선 후 첫 응답+후속 생성 | 총시간 감소 |
|---|---|---|---|
| 입력 처리 대기가 큰 경우 | 20초+10초=30초 | 5초+8초=13초 | 약56.7% |
| 긴 출력 대기가 큰 경우 | 2초+100초=102초 | 0.5초+80초=80.5초 | 약21.1% |
똑같은 두 배율을 적용했지만 첫 사례는 17초, 둘째는 21.5초를 줄인다. 절대 절약 시간은 둘째가 크고 감소율은 첫째가 크다. 모델 속도 개선을 작업 가치로 읽을 때는 비율뿐 아니라 실제로 기다리던 시간도 필요한 이유다.
문서 요약을 자주 새로 시작하는 작업과 긴 초안을 한 번 생성하는 작업은 이 비중부터 다르다. 앞의 예시를 자기 작업의 예상 시간으로 그대로 쓰기보다, 실제 기록에서 응답 시작과 후속 생성이 각각 몇 초인지 나누면 계산할 수 있다. 입력을 읽는 시간과 답변이 완성되는 시간을 한 스톱워치 숫자로만 남기면 어느 구간의 개선인지 설명하기 어렵다.
같은 8B라도 양자화·대화 길이가 메모리를 바꾼다
MLX의 통합 메모리 안내에서 CPU와 GPU는 같은 메모리의 배열을 사용할 수 있다. 두 장치 사이의 복사를 줄이는 구조이지만, RAM 전체가 모델 가중치만을 위한 공간이 되는 것은 아니다. 앱과 운영체제, 계산 중인 데이터도 같은 기기의 메모리를 쓴다. 큰 RAM과 빠른 대역폭은 서로 다른 여유를 제공한다.
모델 이름의 매개변수 수만으로 실행에 필요한 RAM을 고정하기도 어렵다. 같은 모델을 더 낮은 정밀도로 저장하는 양자화는 가중치의 공간을 줄인다. 반면 길어진 대화에서는 이미 계산한 정보를 보관할 공간이 더 필요하다. 다운로드 파일이 들어갈 SSD가 충분한지와 실행 중 RAM에 작업이 들어가는지는 다른 질문이다.
Hugging Face의 KV 캐시 설명에 따르면 모델은 앞선 토큰의 attention 계산 결과를 보관해 다시 쓴다. 매번 같은 계산을 반복하지 않는 대신 캐시가 메모리를 차지한다. 대화 기록을 늘리거나 여러 요청을 함께 유지한 실행은 짧은 질문 하나의 측정과 메모리 조건이 달라진다. 모델 파일의 양자화 표기만으로 캐시 형식과 용량까지 정해지지는 않는다.
예를 들어 짧은 대화에서 안정적이던 실행이 긴 문서를 추가한 뒤 느려졌다면, 먼저 모델이 바뀌었는지와 입력·캐시가 커졌는지를 나눌 수 있다. GPU 점수가 같아도 저장하고 처리할 데이터가 달라졌기 때문이다. 용량과 대역폭을 혼동하기 쉽다면 M2 Pro·M3 Pro의 메모리 용량과 대역폭 비교에서 GB와 GB/s가 서로 다른 선택을 설명하는 사례를 볼 수 있다.
입력 길이가 만드는 차이는 공개 실행 기록에서도 드러난다. galashko의 M5 Max 장문 시험은 128GB 기기에서 Qwen3.6-35B-A3B 4bit를 MLX 0.32.0·mlx-lm 0.31.3으로 실행했다. 입력을 8k에서 192k토큰으로 늘리자 첫 응답은 2.4초에서 203.1초, MLX 최고 메모리는 21.7GB에서 38.0GB로 늘었다. 두 번 실행한 기록의 중앙값이며, 기본형 M5와의 속도 비교가 아니라 같은 기기에서도 입력 길이가 대기와 메모리를 함께 바꾼다는 사례다.
같은 문서를 두 번째 넣었을 때 빨라지는 이유
MLX LM 공식 안내는 프롬프트 캐시와 크기를 제한한 KV 캐시를 별도 기능으로 제공한다. 공통 입력의 처리 결과를 재사용하는 실행과 처음부터 처리하는 실행을 섞으면, 같은 맥에서도 첫 응답 시간이 달라진다. 질문 내용이 같다는 사실만으로 같은 일을 다시 계산했다고 결론 낼 수는 없다.
따라서 M4에는 처음 보는 문서를 넣고 M5에는 캐시가 남은 문서를 넣은 결과는 세대 차이를 고립시키지 못한다. 반대로 캐시를 잘 쓰는 실제 업무의 체감을 알고 싶다면 두 기기 모두 같은 캐시 상태에서 반복하는 비교가 맞다. 새 문서의 첫 요청과 같은 자료의 후속 질문을 각각 기록하면 두 용도에 대한 답을 얻는다.
캐시 공간을 줄이는 설정에도 대가가 있다. 공식 README는 회전형 KV 캐시의 크기를 작게 잡으면 RAM을 덜 쓰지만 품질이 나빠질 수 있다고 설명한다. 긴 문맥을 보존하는 조건까지 바꿔 얻은 속도를 같은 답변 작업의 개선으로 볼 수는 없다. 빠르게 출력됐는지와 필요한 앞 문맥을 유지했는지는 별도로 비교할 항목이다.
일반 GPU 벤치에서는 약33% 차이가 나왔다
Notebookcheck의 M5 맥북프로 직접 리뷰에서 Geekbench 6.7 GPU Metal은 M5 77,007점, 비교표의 M4 57,998점이다. 산술 차이는 약32.8%다. 이 시험의 M5는10CPU·10GPU·32GB·1TB, M4는10CPU·10GPU·16GB·512GB다. Apple MLX의24GB 기기 비교와도 다른 자료다.
Metal 점수33%와 LLM 첫 응답4배는 서로 모순된 결과가 아니다. 시험에 쓰인 연산과 실행 환경, 지표가 다르기 때문이다. 전자는 일반 GPU 벤치 점수이고 후자는 특정 모델·입력에서의 응답 지연이다. 이 두 값의 차이를 부풀림이나 측정 실패로 판정하려면 먼저 같은 작업을 비교했다는 전제가 있어야 한다.
런타임도 결과를 바꾼다. llama.cpp의 M5 커널 조정 보고는 같은 칩의 단일 토큰 생성에서도 연산 코드의 조정이 영향을 주는 사례다. 작성자가 LLaMA3.2 1B Q4_K_M으로 생성64토큰을 시험한 보고이며, M4와 M5의 통제 비교는 아니다. 하드웨어가 같다는 이유로 다른 버전의 실행 결과까지 같은 출발점으로 묶지 않는 근거가 된다.
2026년 7월 공개된 BaseRT 연구도 M5 Pro에서 큰 행렬을 처리하는 입력 단계에 Neural Accelerator를 쓰고, 후속 생성에는 별도의 커널을 사용한다. 이 연구의 비교 대상은 같은 M5 Pro의 실행 엔진들이다. M4 대비 배율을 더하는 자료로 쓰기보다, 앱과 런타임이 어느 단계에서 새 연산 장치를 사용하는지에 따라 결과가 달라지는 근거로 읽는 편이 맞다.
내 작업에서는 어느 구간이 느린가
비교 기록의 단위는 칩 이름보다 구체적이어야 한다. 모델이 같아도 양자화·입력 길이·캐시가 달라지면 처리할 일이 달라진다. 다음 항목을 함께 남기면 첫 응답의 변화와 생성의 변화를 설명할 재료가 생긴다.
| 기록 항목 | 같게 맞출 조건·읽는 값 |
|---|---|
| 기기와 실행 환경 | 칩·GPU 코어·RAM·OS·앱과 런타임 버전 |
| 모델 | 저장소·개정판·양자화 형식 |
| 입력 | 실제 토큰 수·대화 이력·추가 문서 |
| 출력 | 생성 토큰 수·추론 모드·동시 요청 수 |
| 반복 조건 | 모델 로드 완료 여부·프롬프트 캐시 유무 |
| 결과 | 첫 응답 초·후속 생성 tokens/s·전체 초·메모리 상태 |
모델 로드를 마친 뒤 첫 요청부터 느리다면 입력 처리 구간을, 첫 글자는 금방 나오는데 긴 답변이 늦다면 후속 생성 구간을 따로 본다. 첫 실행만 느리고 반복하면 빨라진다면 로드와 캐시 조건도 설명에 들어간다. 이 기록은 서로 다른 원인을 모두 ‘M5 AI 성능’이라는 한 숫자로 뭉개지 않게 한다.
세대별 코어·메모리 선택 범위가 필요한 경우에는 M1부터 M5 Max까지의 칩 구성 비교가 다음 질문을 맡는다. 여기서 확인한 결론은 더 좁다. M5의 GPU 연산 강화가 응답 시작을 크게 줄인 시험에서도, 뒤이어 글을 만드는 속도와 응답 전체 시간은 각 단계의 병목과 비중에 따라 달라진다.